En bref
- Pour commencer avec LM Studio, il vous faut un ordinateur compatible et un modèle téléchargé ; l’éditeur conseille 16 Go de mémoire vive.
- Quand le modèle est téléchargé et tourne sur votre ordinateur, vos documents et vos échanges n’en sortent pas. Avec la recherche web ou un modèle en ligne, votre question et les fichiers joints partent sur Internet.
- LM Studio peut fonctionner hors ligne si les fichiers du modèle sont déjà sur votre ordinateur.
Qu’est-ce qu’une IA en local et pourquoi l’utiliser ?
Une IA en local, c’est un modèle qui tourne sur votre ordinateur, sans passer par le serveur d’une entreprise.
Avec un modèle téléchargé, les documents que vous joignez dans LM Studio restent sur votre machine. D’après l’éditeur, vous pouvez aussi discuter avec ce modèle hors ligne. LM Studio est gratuit à la maison comme au travail. Ses services en ligne s’achètent à part.
Sur mon Mac, la réponse à la question sur le contrat a pris environ 1 minute 20 secondes. J’ai aussi relevé de petites fautes sur d’autres demandes, montrées plus bas.
Quel PC pour faire tourner une IA en local ?
L’éditeur conseille 16 Go de mémoire vive, sur Mac comme sur Windows. Un Mac de 8 Go peut suffire, avec un petit modèle et pas trop de texte à la fois.
- Mac : une puce Apple Silicon et macOS 14 ou plus. Les Mac à processeur Intel ne sont pas pris en charge.
- Windows : un processeur x64 compatible AVX2 ou une machine ARM prise en charge. L’éditeur recommande 4 Go de mémoire vidéo dédiée.
- Linux : LM Studio est distribué en AppImage et demande Ubuntu 20.04 ou plus.
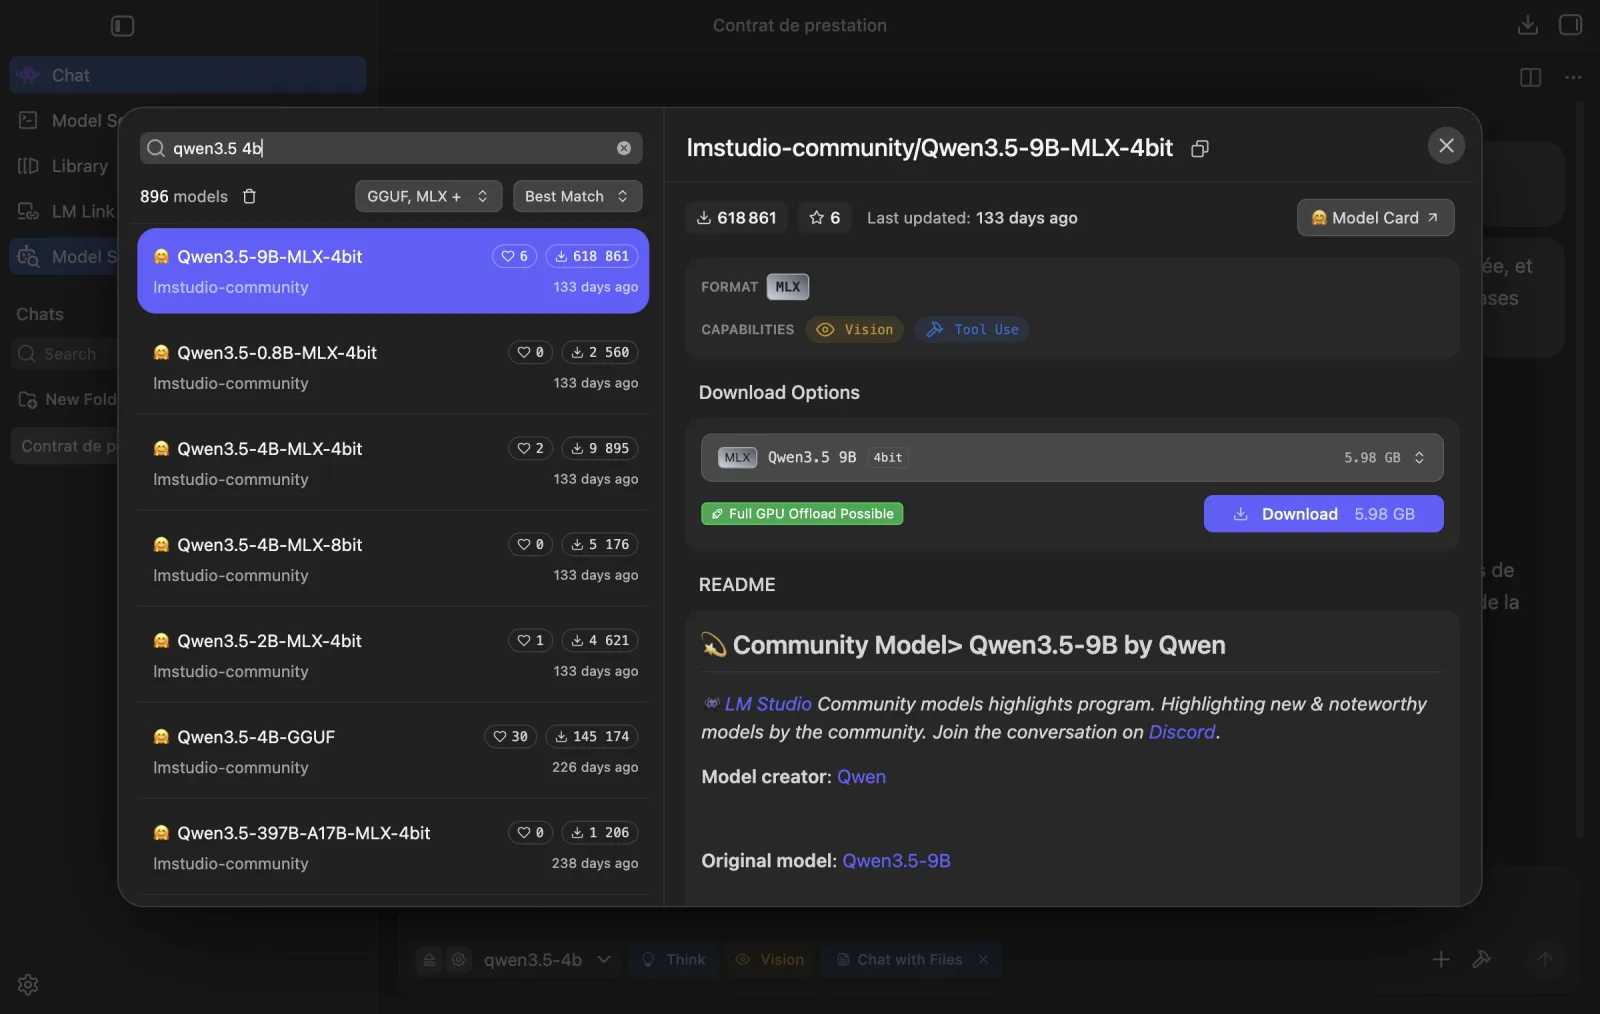
Avant de télécharger un modèle, ouvrez « Model Search » et regardez sa fiche. Sur mon MacBook Pro M3 Pro avec 18 Go de mémoire vive, la fiche de Qwen3.5 9B affiche un badge vert « Full GPU Offload Possible » à côté de « Download 5.98 GB ». Le badge indique que le modèle peut être chargé en entier sur la puce graphique. C’est l’indice à regarder sur votre machine avant de télécharger.
Pour installer l’application de ce tuto, allez sur lmstudio.ai/download et choisissez « Download LM Studio ».
La page présente d’abord « Download LM Studio Bionic ». Bionic est un autre logiciel de l’éditeur, un agent, et ce n’est pas l’application de ce tuto. Plus bas, la partie « Download LM Studio » porte le sous-titre « Experiment with LLMs on your computer ».
- Ouvrez lmstudio.ai/download.
- Descendez jusqu’à « Download LM Studio ».
- Vérifiez que le système affiché est le vôtre. Sur la page vue depuis mon Mac, le bouton indique « Download LM Studio for macOS ».
- Téléchargez l’application, installez-la et ouvrez-la.
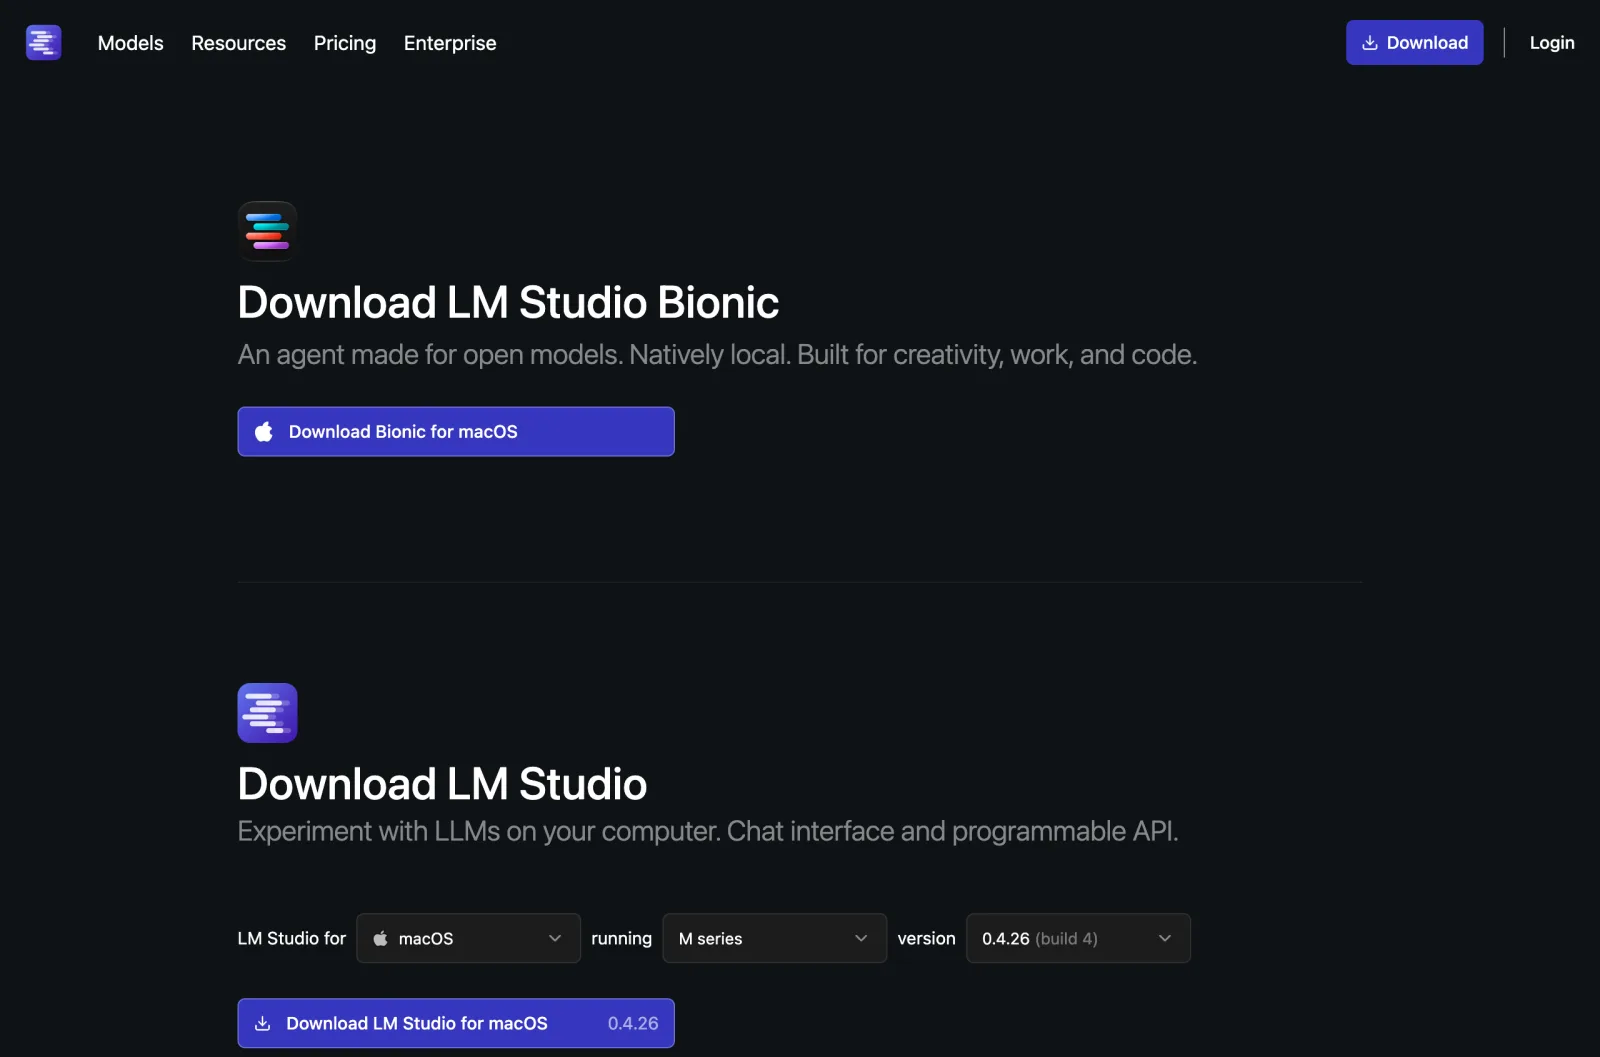
La version relevée le 14 octobre 2026 est la 0.4.26. À la première ouverture, il reste à télécharger un modèle.
Quelle IA faire tourner en local ?
La mémoire vive disponible limite la taille du modèle que LM Studio peut charger.
Pour choisir, partez de la mémoire vive de votre ordinateur. Avec 8 Go, regardez les plus petites tailles : Qwen3.5 2B ou 4B, ou Granite 4.1 3B. Avec 16 Go, vous pouvez regarder Qwen3.5 9B. OpenAI indique aussi que gpt-oss-20b peut tourner avec 16 Go de mémoire. Avec 32 Go, les fiches de Qwen3.5, Gemma 4 et Granite 4.1 annoncent jusqu’à 21 Go pour leurs plus grandes versions. Dans tous les cas, lisez « Memory Requirements » sur la fiche, puis vérifiez le badge de compatibilité affiché sur votre machine.
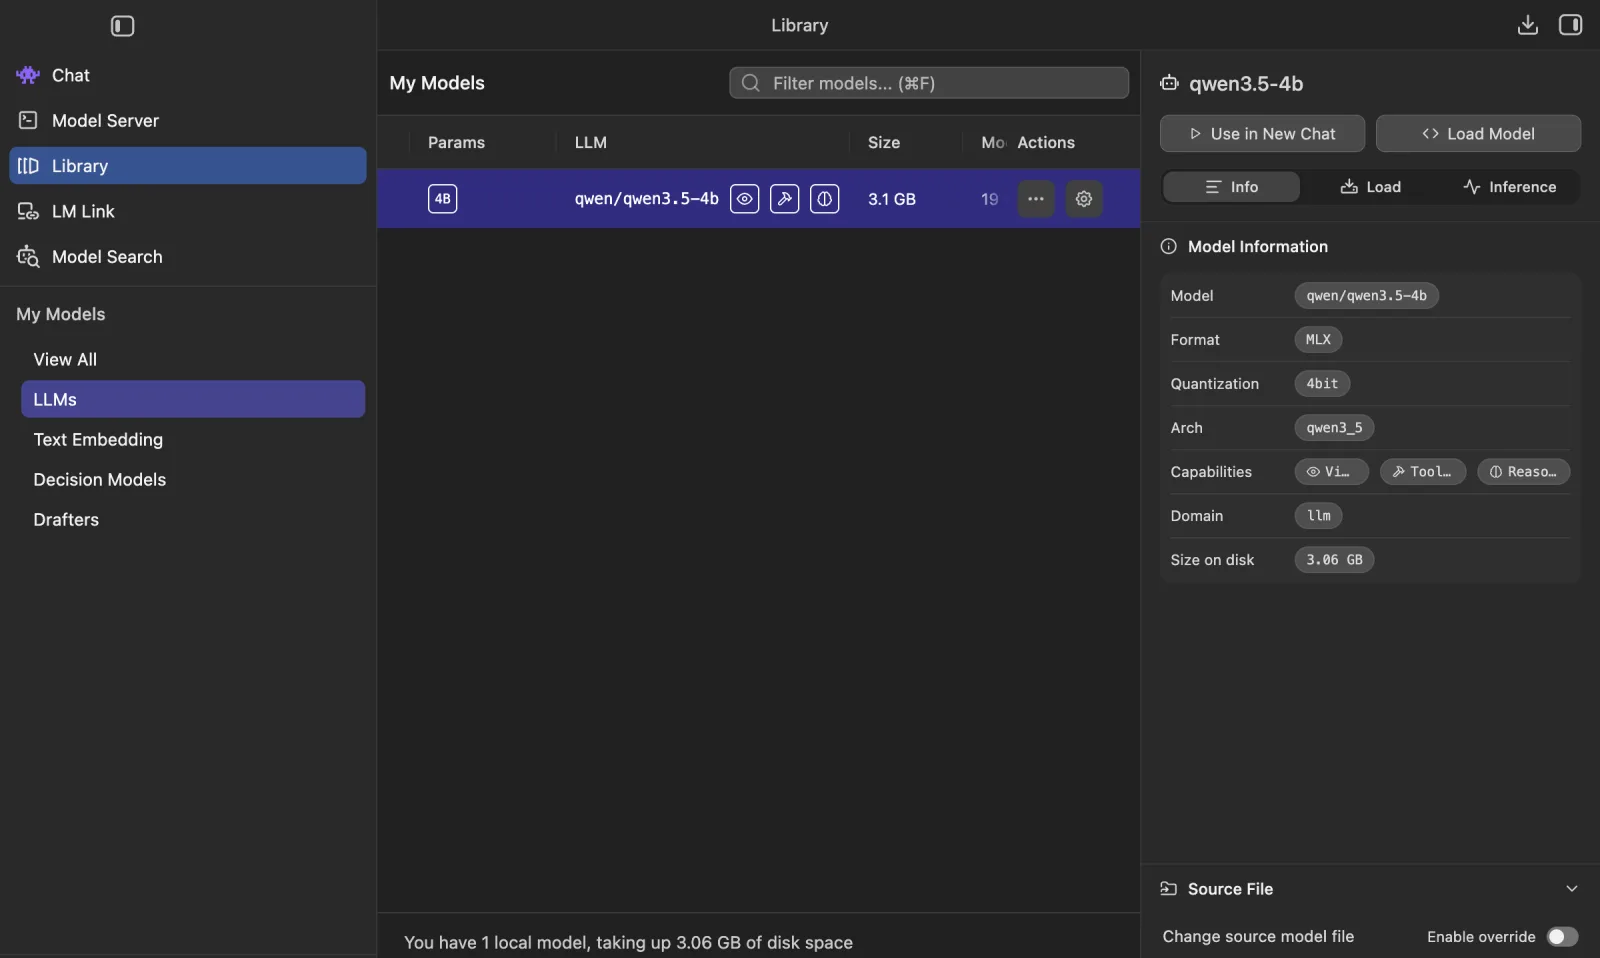
Pour la question sur le contrat d’exemple, Qwen3.5 4B a suffi. Le « 4B » désigne ses 4 milliards de paramètres. J’ai pris sa version MLX 4 bits, qui occupe 3,06 Go sur le disque.
LM Studio prend en charge les modèles MLX sur les Mac à puce Apple. Il fait tourner les modèles GGUF sur Mac, Windows et Linux.
- Ouvrez « Model Search » dans la barre de gauche.
- Cherchez « qwen3.5 4b ».
- Sur un Mac à puce Apple, choisissez « Qwen3.5-4B-MLX-4bit ». Sous Windows ou Linux, choisissez la fiche « Qwen3.5-4B-GGUF ».
- Cliquez sur « Download ». Une fois le téléchargement terminé, la fiche affiche « Applicable model file already downloaded » et « Use in New Chat ».
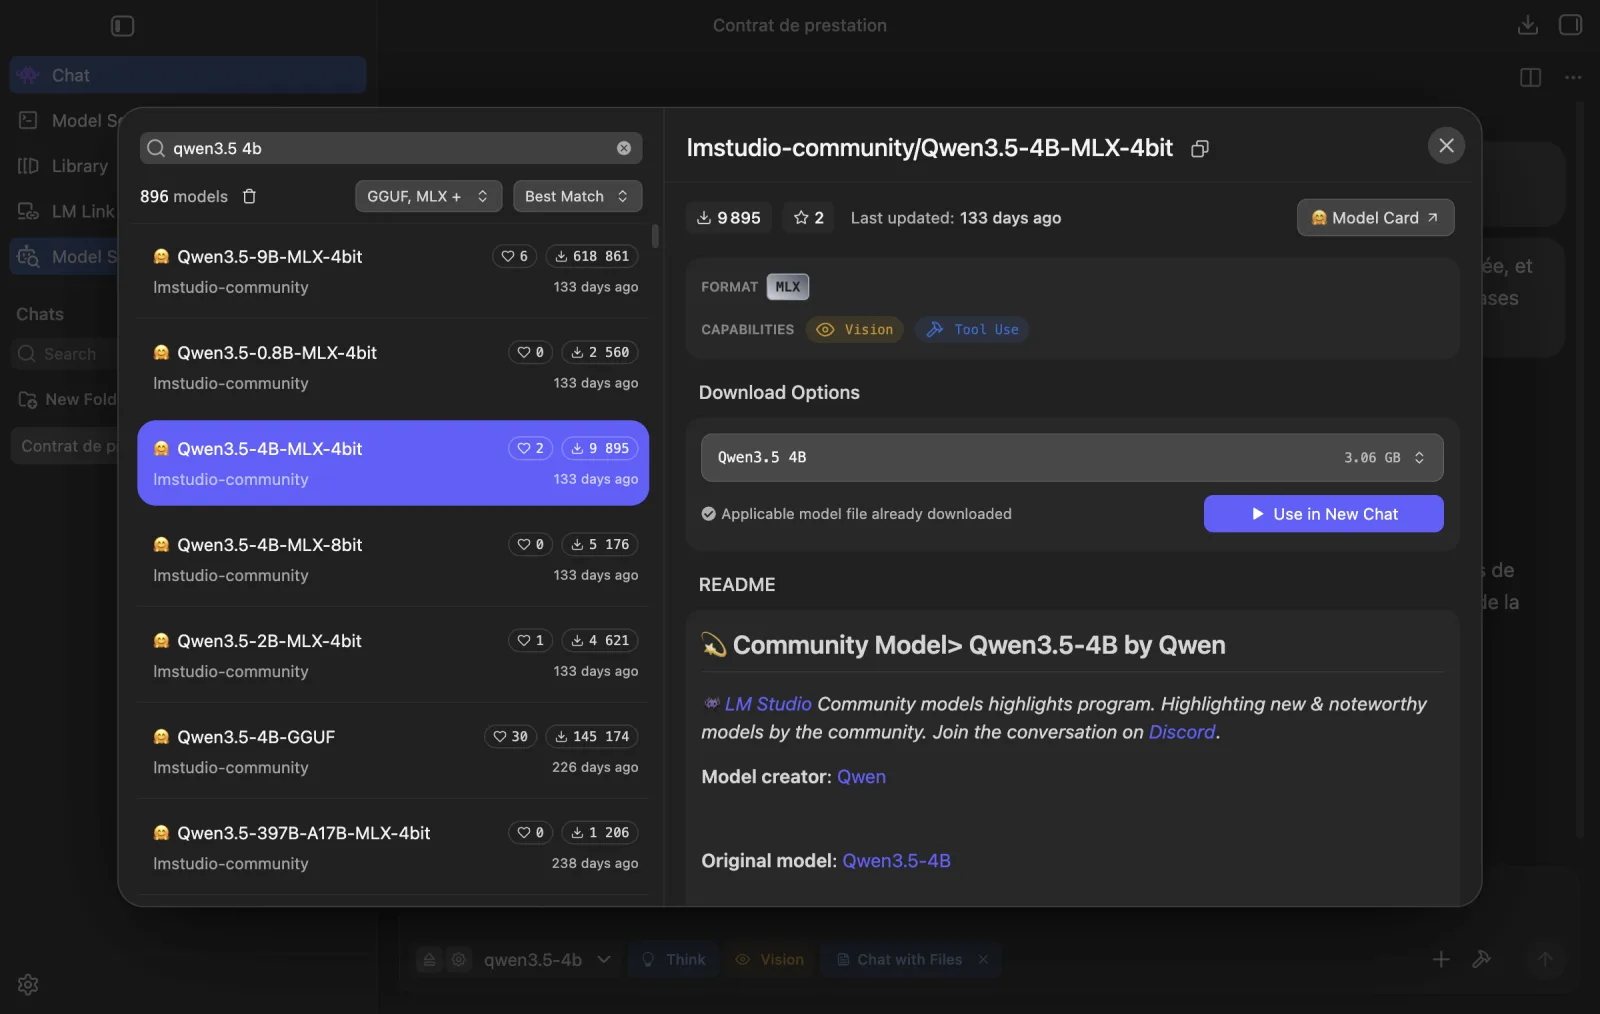
Les versions d’un même modèle sont plus ou moins compressées. Une version plus compressée prend moins de place, avec une perte possible de fidélité. L’éditeur conseille une version 4 bits ou plus si votre machine peut la charger.
Sur mon Mac, la recherche affiche « Qwen3.5-4B-MLX-4bit », « Qwen3.5-4B-MLX-8bit » et « Qwen3.5-4B-GGUF ». Le filtre indique « GGUF, MLX + ». Vous retrouverez le modèle, sa taille et son format dans « Library ».
Que répond LM Studio à une question sur ce contrat ?
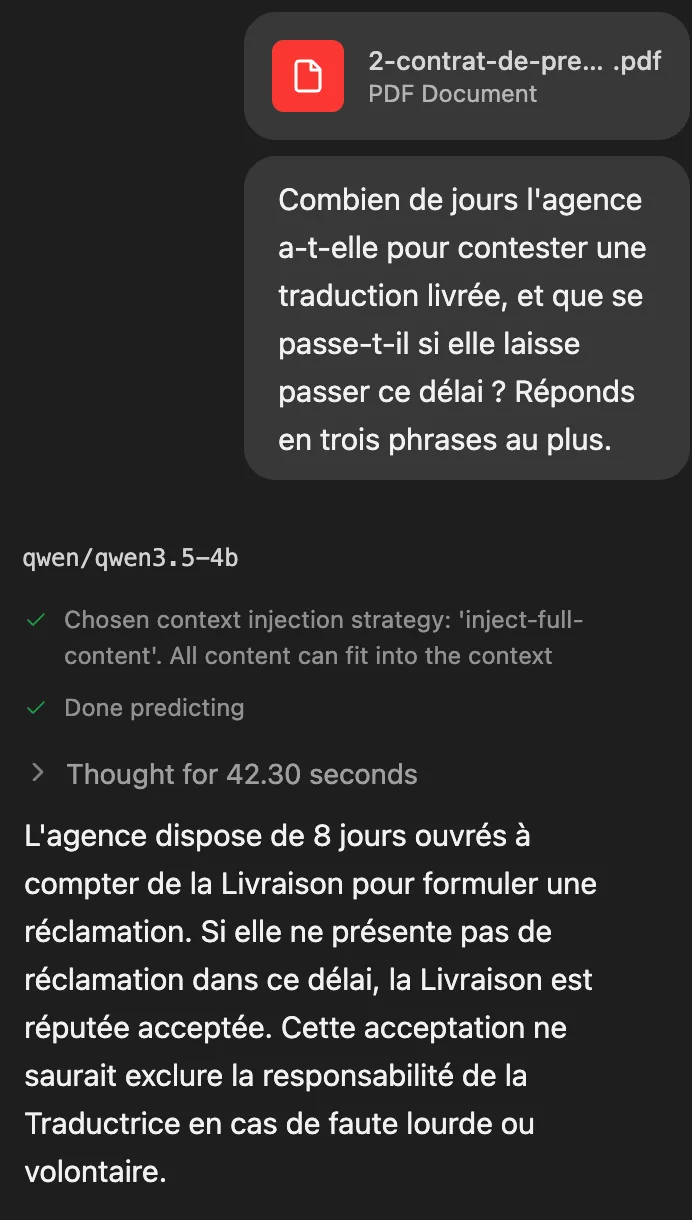
Qwen3.5 4B a trouvé le délai de 8 jours ouvrés indiqué à l’article 7.5 du contrat.
Le PDF est un « Contrat-cadre de prestations de traduction » fictif. Il lie Atelier Verbatim SAS à Claire Vasseur, traductrice indépendante.
- Ouvrez une nouvelle conversation, puis le sélecteur du bas « Pick a model (⌘L) ».
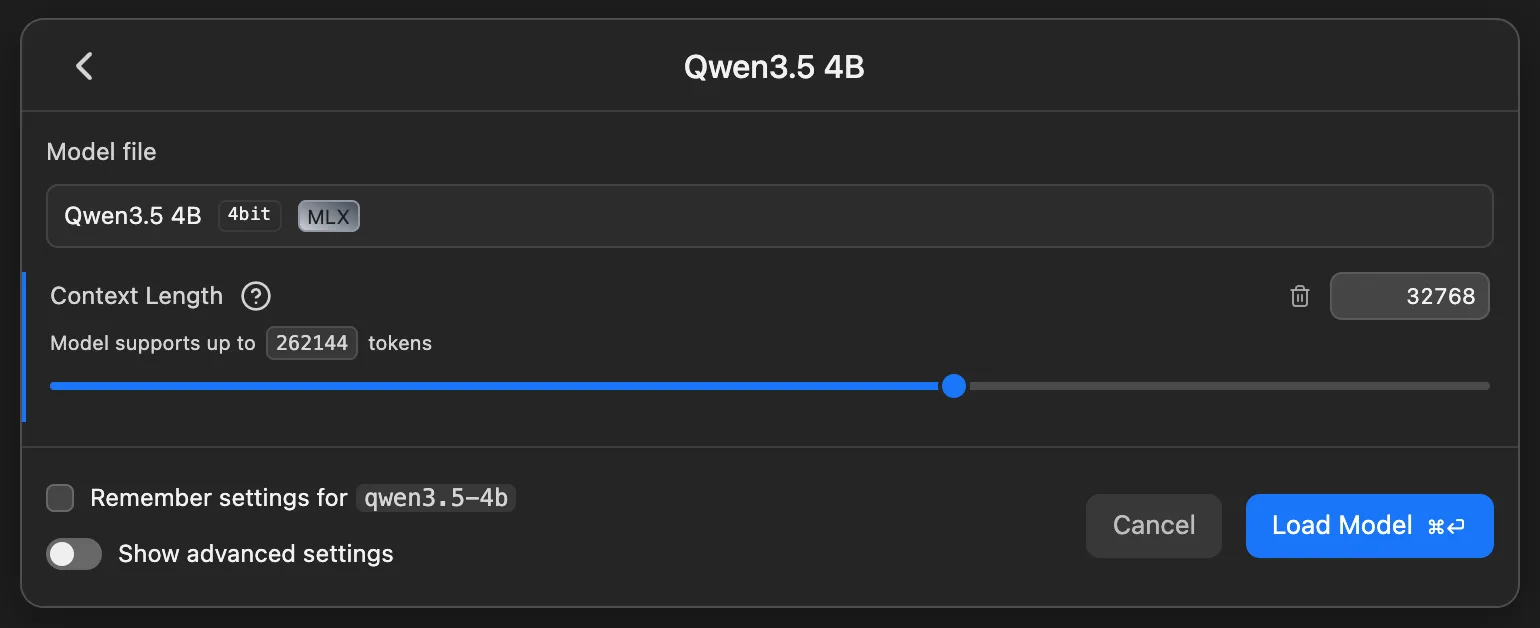
- Choisissez « Open model loader », activez « Manually choose model load parameters » et sélectionnez « Qwen3.5 4B ».
- Dans « Context Length », remplacez 8192 par 32768. Ce réglage fixe la mémoire de travail du modèle, comptée en jetons. D’après l’éditeur, un jeton correspond souvent aux trois quarts d’un mot. Le contrat compte 13 849 jetons : avec la valeur par défaut, il ne tient pas en entier. LM Studio peut alors ne donner au modèle que des passages du document.
- Cliquez sur « Load Model ».
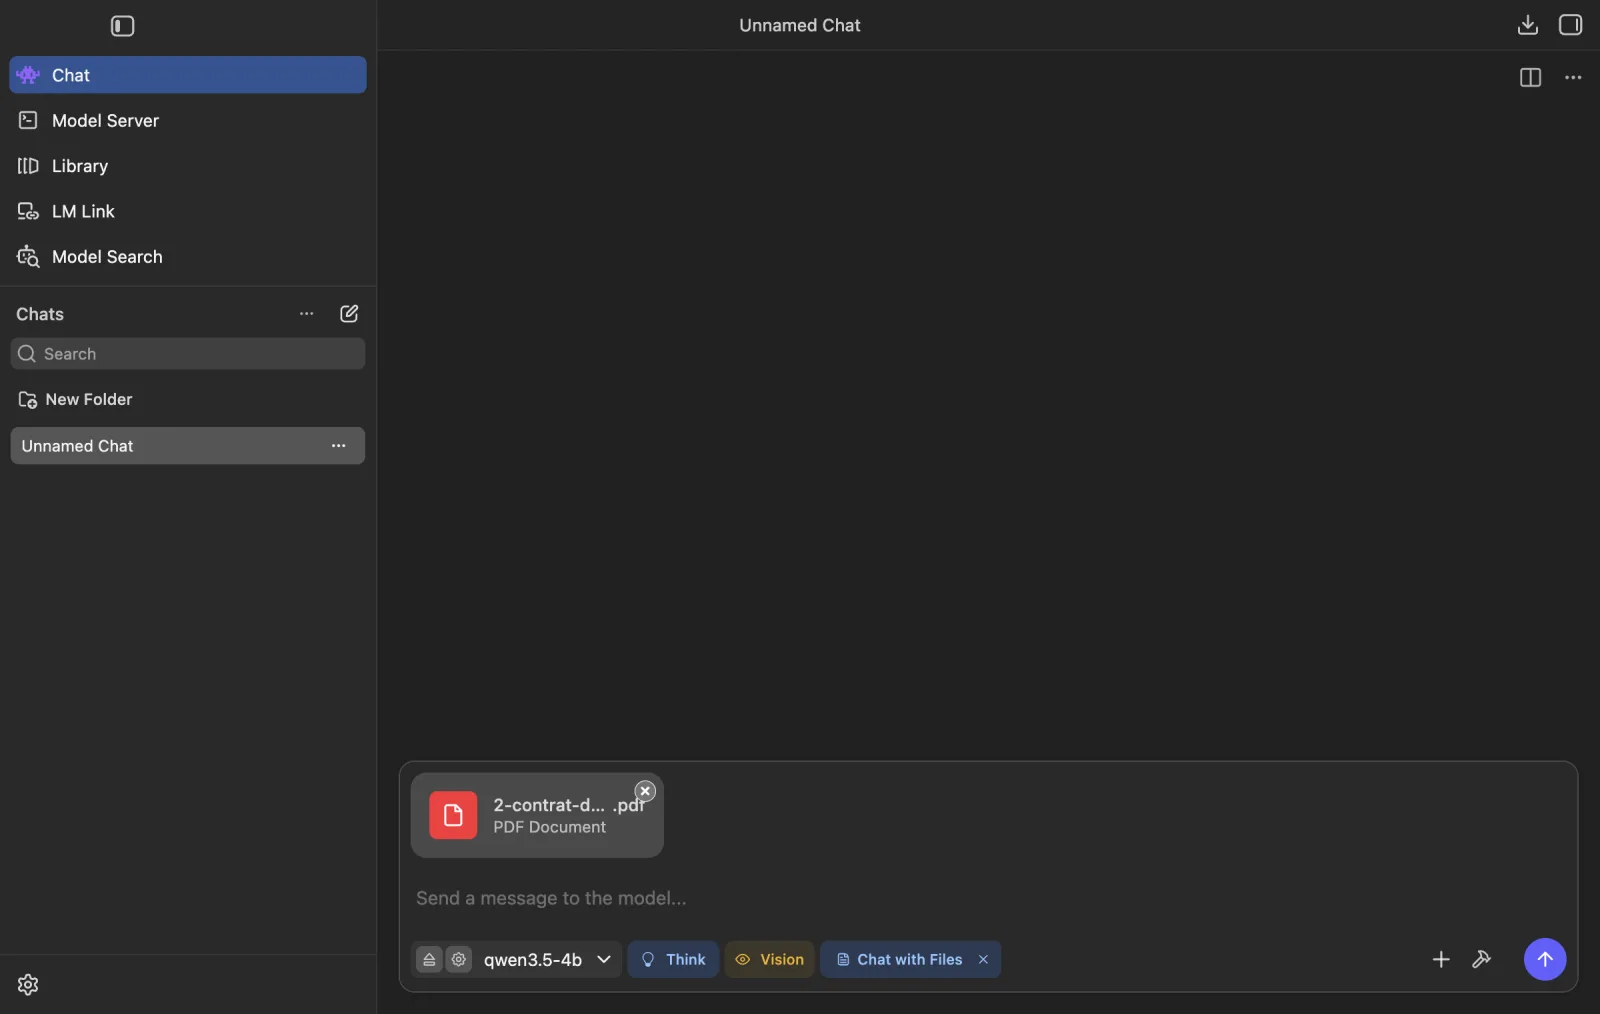
Joignez le PDF avec le bouton « + ». Le fichier apparaît au-dessus du champ de saisie.
Voici la question que j’ai envoyée :
Combien de jours l’agence a-t-elle pour contester une traduction livrée, et que se passe-t-il si elle laisse passer ce délai ? Réponds en trois phrases au plus.
La ligne grise « Chosen context injection strategy: ‘inject-full-content’. All content can fit into the context » indique que LM Studio a donné le contrat entier au modèle.
Voici la réponse exacte du modèle :
L’agence dispose de 8 jours ouvrés à compter de la Livraison pour formuler une réclamation. Si elle ne présente pas de réclamation dans ce délai, la Livraison est réputée acceptée. Cette acceptation ne saurait exclure la responsabilité de la Traductrice en cas de faute lourde ou volontaire.
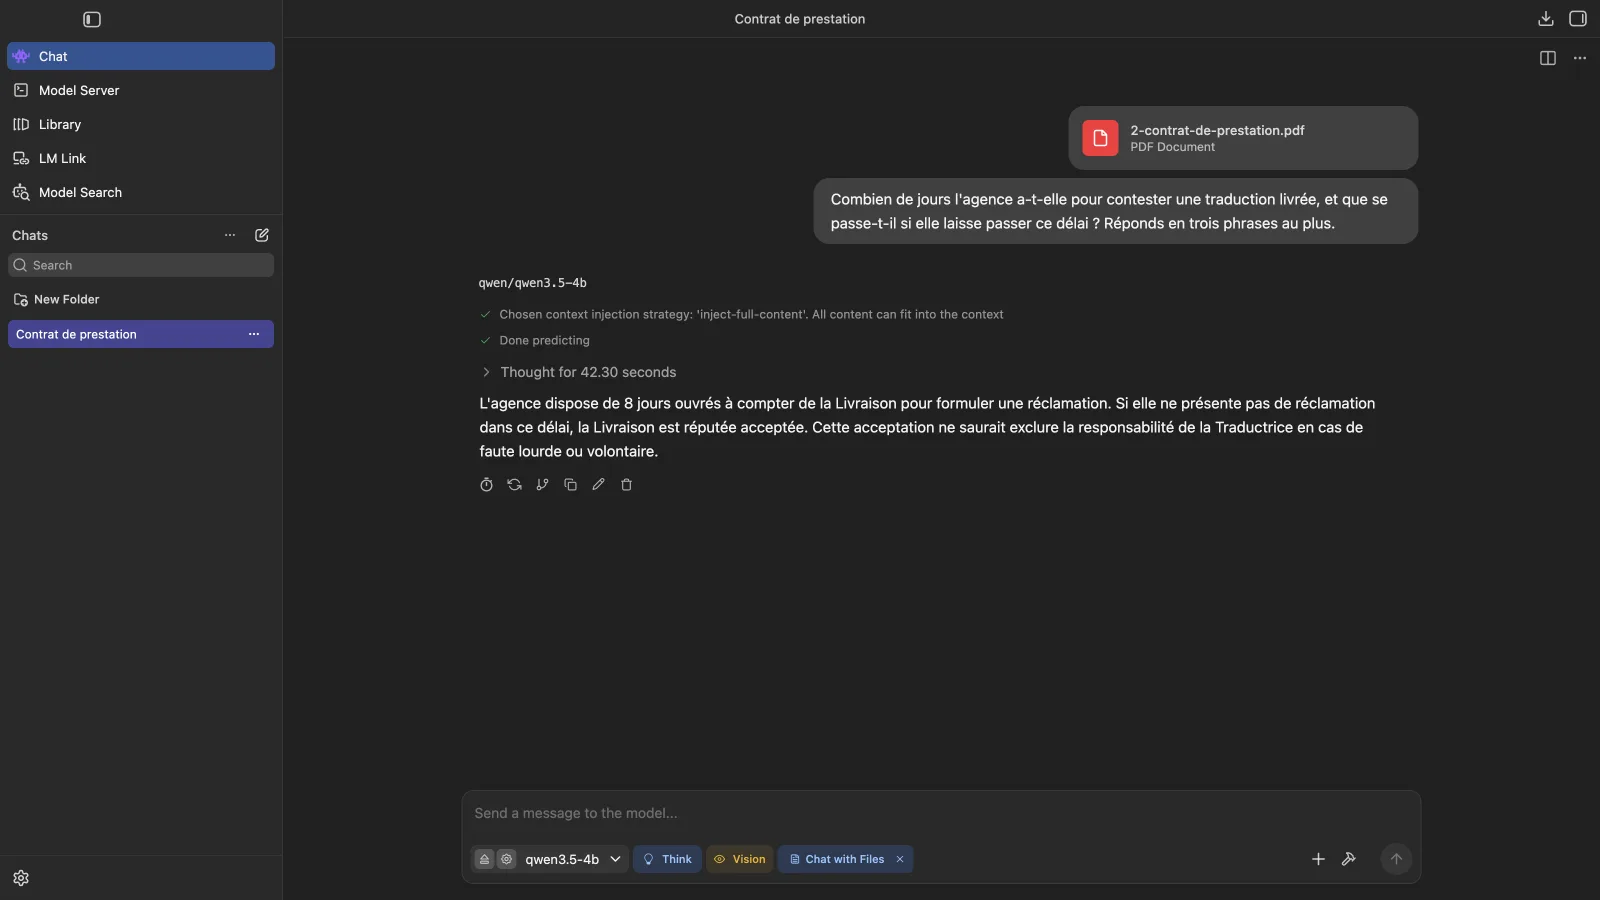
La réponse complète est arrivée 79,3 secondes après l’envoi de la question, soit environ 1 minute 20 secondes. Le modèle a commencé à réfléchir après 33,6 secondes. LM Studio affiche « Thought for 42.30 seconds » pour cette réflexion. La réflexion est écrite en anglais et la réponse est en français.
Le contrat est dans un dossier d’essai gratuit pour LM Studio qui rassemble les documents fictifs de Claire. Ce dossier contient aussi les informations d’un mail à faire rédiger, des factures, un bon de commande scanné, un texte à traduire et deux préréglages. Pour chaque fichier, le dossier donne la demande à taper et ce que la bonne réponse doit contenir.
Si votre document peut être envoyé en ligne, vous pouvez suivre mon tuto pour résumer un PDF avec ChatGPT, Claude, Copilot ou Gemini.
Garder une consigne pour la conversation suivante
J’ai préparé deux préréglages pour les autres tâches de Claire. Un préréglage conserve une consigne que vous pourrez réutiliser. Dans le panneau de droite, sous « Preset », ouvrez « Select a Preset… ». La liste propose « Import Preset », qui ouvre la fenêtre de choix de fichier du Mac. Choisissez-y le fichier du préréglage. La liste montre ici « Relances de Claire » et « Traduction Atelier Verbatim ».
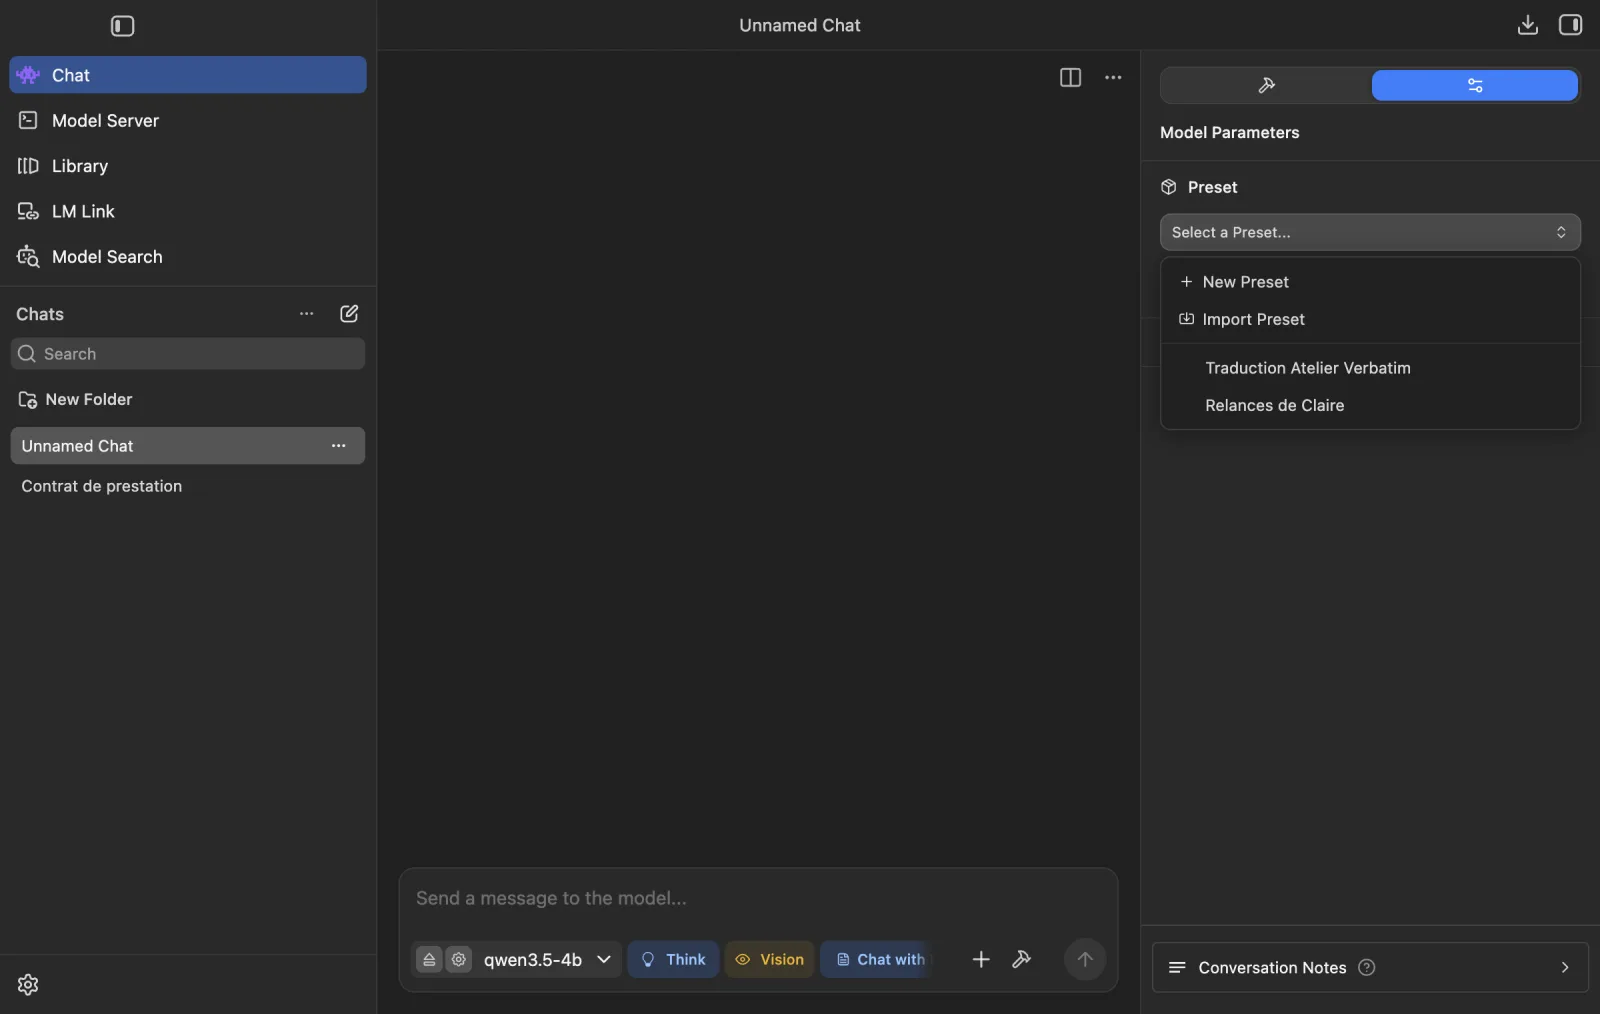
Vérifiez le préréglage affiché avant d’envoyer votre demande. Une nouvelle conversation garde celui de la précédente : lors de mon premier essai, la brochure à traduire a reçu un mail de relance parce que « Relances de Claire » était encore choisi.
Avec LM Studio, vos documents restent-ils sur votre ordinateur ?
Vos documents restent sur votre ordinateur quand vous utilisez un modèle téléchargé qui tourne sur votre machine. Les services en ligne payants de LM Studio, comme les modèles en ligne et la recherche web, transmettent la question et les fichiers joints quand vous les utilisez.
Selon l’éditeur, un document joint à une conversation avec un modèle local est traité sur votre machine. La recherche et le téléchargement de modèles passent par Internet. À l’ouverture, l’application se connecte aussi pour vérifier les mises à jour.
Je n’ai pas coupé le Wi-Fi pendant ces essais. Les précisions sur les données envoyées viennent de la documentation de LM Studio.
Quelles sont les limites de l’IA en local pour lire un contrat ?
Pendant mes essais, les limites les plus visibles ont été le temps de réponse et les petites fautes. La réponse sur le contrat était juste, mais elle a pris environ 1 minute 20 secondes.
La première traduction a pris 3 minutes 24 secondes. Lors des essais suivants, une traduction a demandé près de 5 minutes. Le mail de relance de dix lignes a nécessité 2 minutes 9 secondes de réflexion.
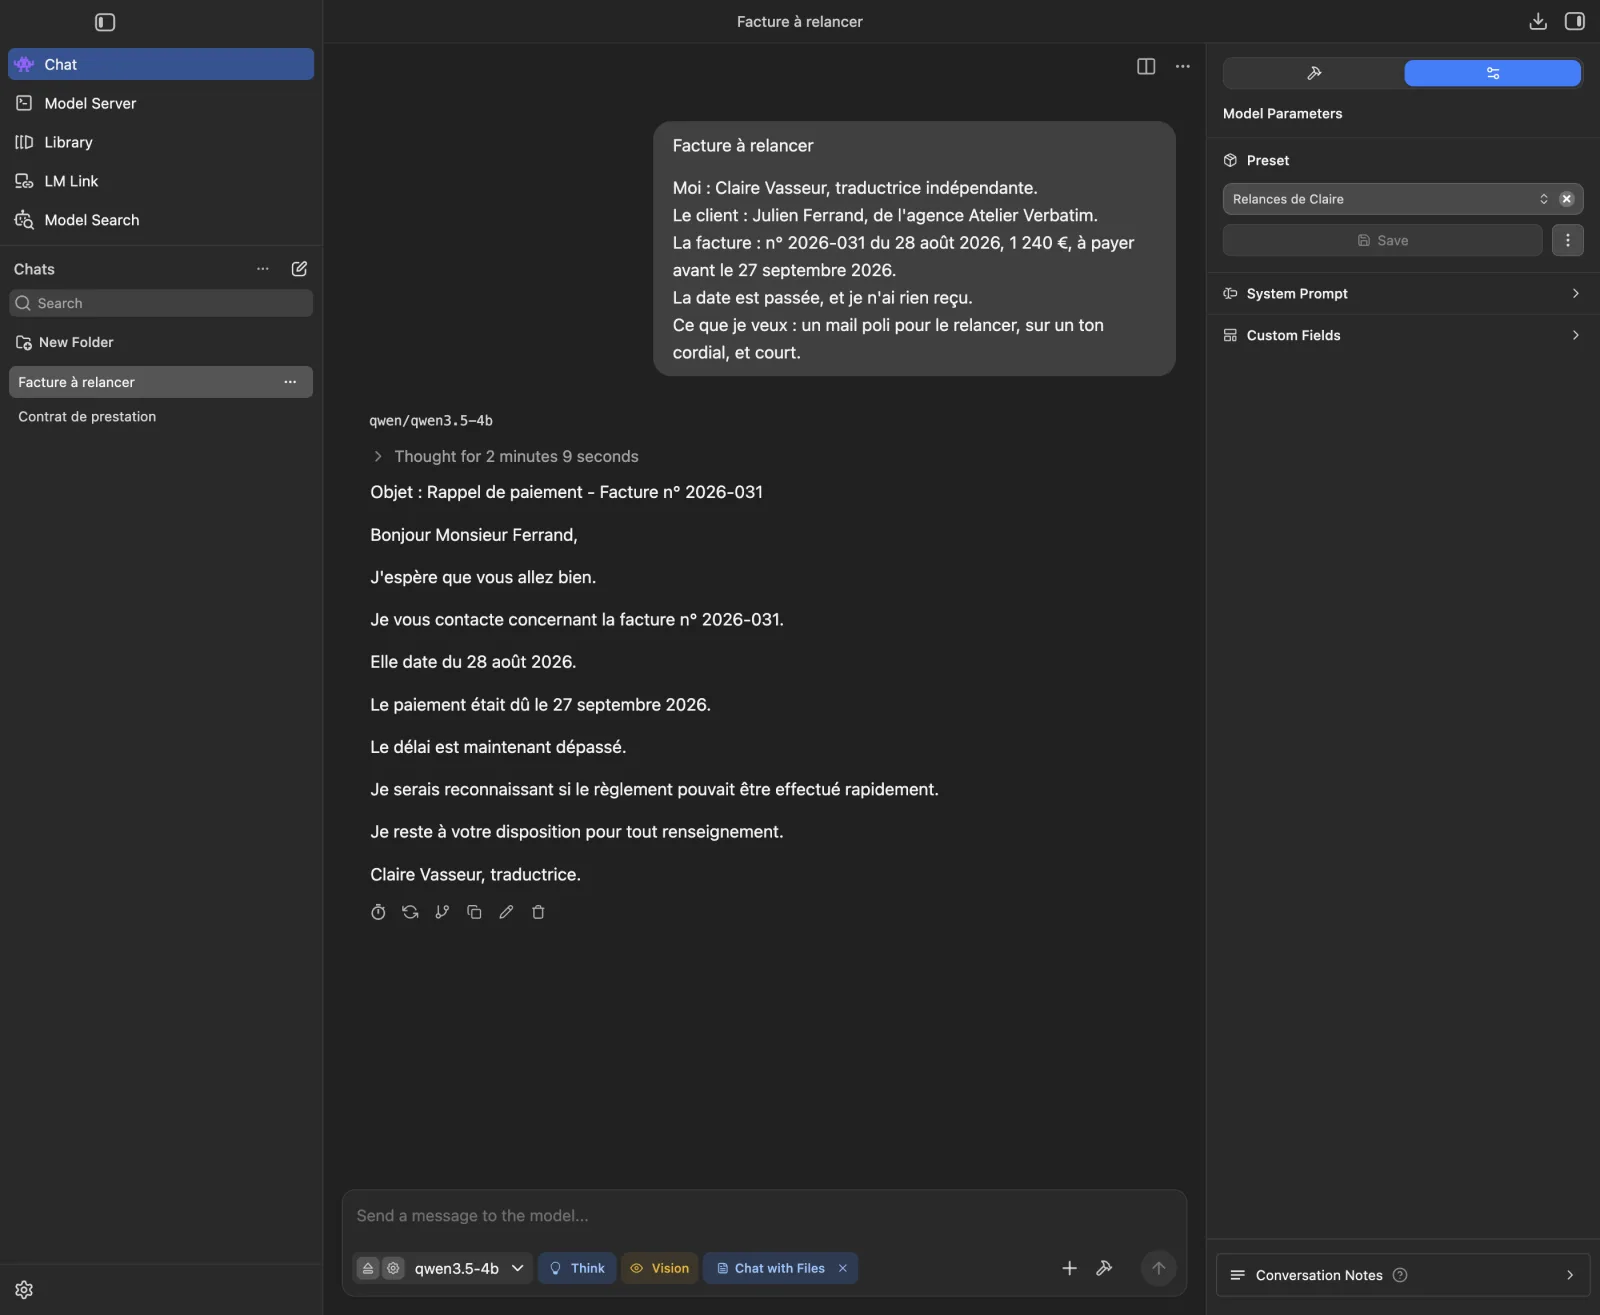
Au premier essai de « Relances de Claire », le modèle a écrit « Je serais reconnaissant » au masculin, alors que Claire est une femme. Il a aussi oublié les 1 240 €. Après correction de la consigne, le montant figurait dans trois essais sur trois, sans accord au masculin.
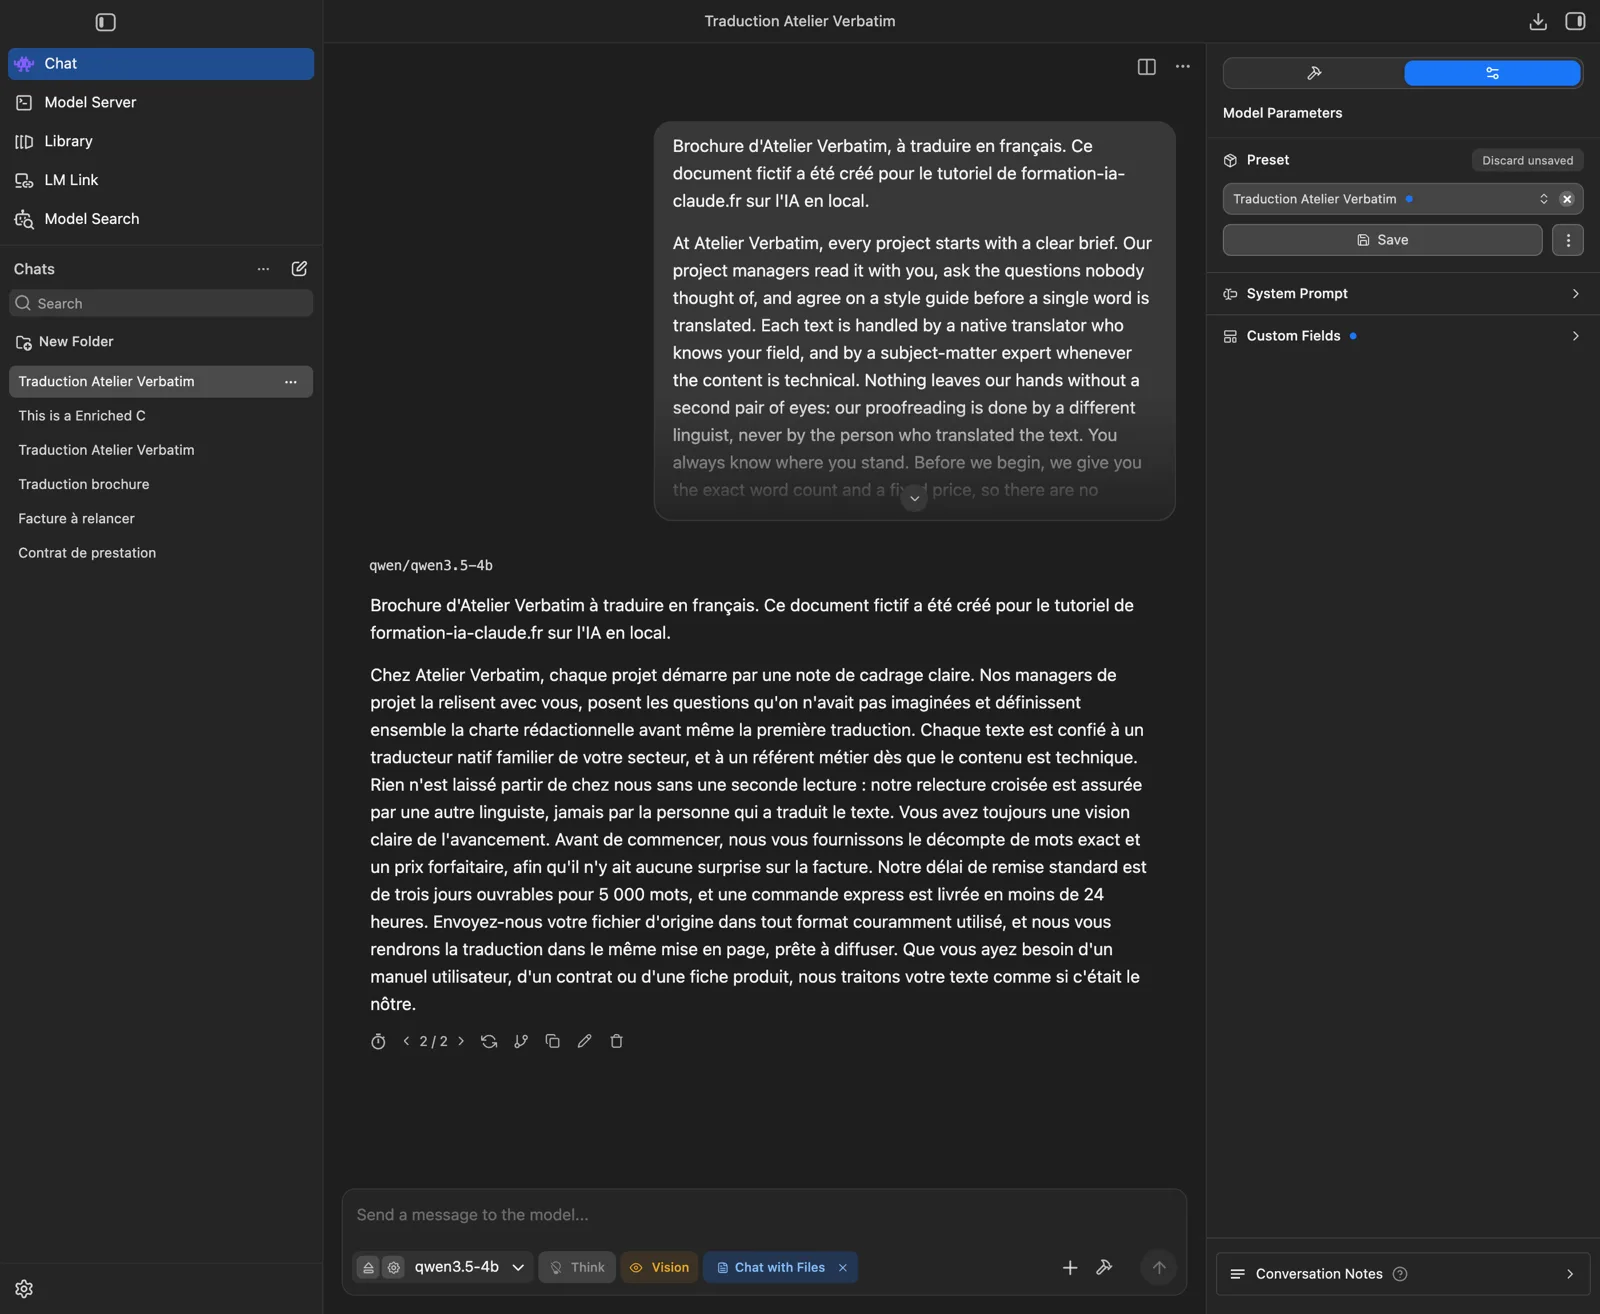
La première traduction reprenait les huit termes imposés par l’agence dans le préréglage. Elle écrivait pourtant « Nos chefs de projet le relisent » à propos d’une note de cadrage : il fallait « la ». Elle écrivait aussi « prête à publication » au lieu de « prête à publier ». Après correction de la consigne, il restait une ou deux maladresses par traduction, comme « une seconde vue » ou « les questions jamais prévues ».
Je n’ai posé la question sur le contrat qu’une fois avec la réflexion du modèle activée. Ce résultat ne dit donc pas si le modèle retrouverait le délai à chaque essai. Je relis ses réponses comme je relirais le travail d’un stagiaire.
LM Studio ou Ollama : lequel choisir ?
Pour poser une question sur un document, j’ai utilisé LM Studio. Ollama est une autre possibilité, que je n’ai pas essayée pour ce tuto.
Ollama existe sur Mac, Windows et Linux. Son site propose une commande d’installation ou un fichier à télécharger. Il distingue les modèles qui tournent sur l’ordinateur des modèles qui tournent sur ses serveurs. Le nom d’un modèle sur ses serveurs se termine par « :cloud ». Pour garder vos fichiers sur votre machine, choisissez un modèle local.
LM Studio peut aussi servir de serveur local à d’autres logiciels, d’après son éditeur. Ce tuto reste centré sur la conversation dans l’application.
Que faire si LM Studio ne fonctionne pas ?
Vous avez peut-être installé Bionic, choisi un modèle trop gros pour votre mémoire vive ou trouvé la réponse très lente.
Si vous avez installé Bionic, revenez à lmstudio.ai/download et choisissez « Download LM Studio ». Bionic est l’agent présenté au-dessus sur cette page.
Si le modèle ne se charge pas, essayez-en un plus petit ou réduisez la longueur de contexte. Charger un modèle demande de la mémoire vive. Sur un Mac de 8 Go, l’éditeur conseille justement un petit modèle et un contexte modeste.
Si la réponse tarde, regardez la ligne « Thought for… » : elle indique combien de temps le modèle a réfléchi. Le bouton « Think », en bas de la conversation, à côté du nom du modèle, règle cette réflexion. J’ai refait une fois la question sur le même contrat, dans une nouvelle conversation, avec « Think » éteint. Le bouton était grisé, avec une ampoule barrée.
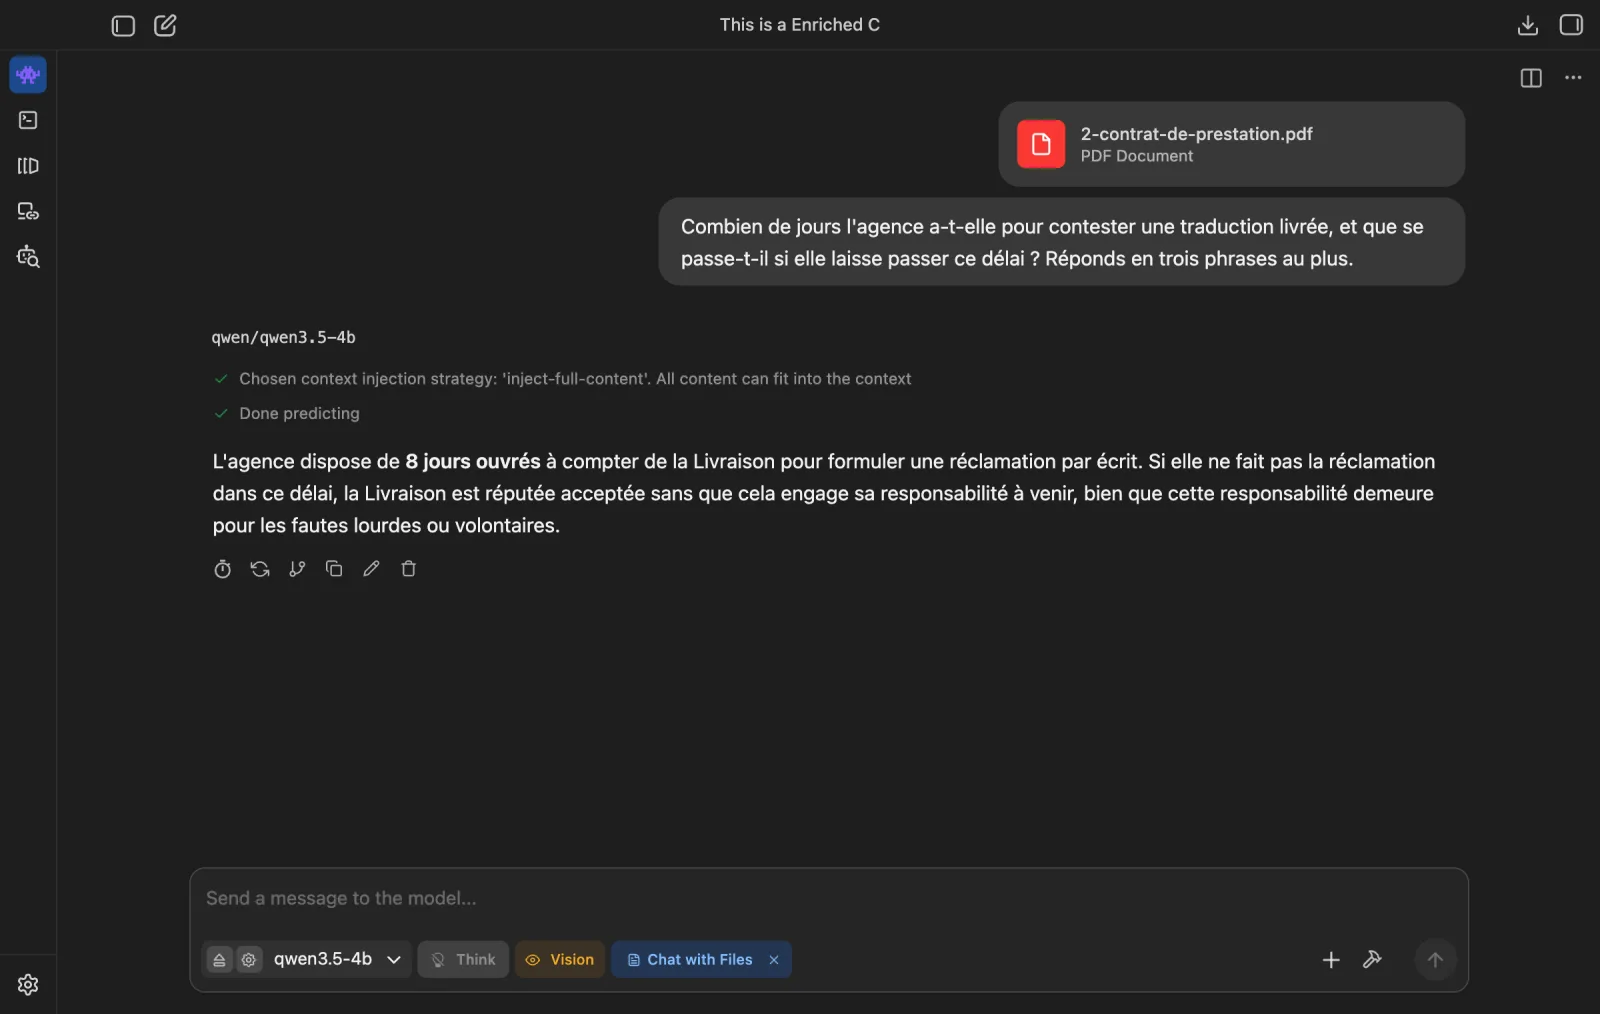
Cette fois, la réponse complète est arrivée en 32,9 secondes, dont 30,5 secondes avant le premier mot. Le délai de 8 jours ouvrés était juste. La deuxième phrase désignait moins clairement la personne qui reste responsable en cas de faute lourde ou volontaire. Éteindre « Think » n’a pas supprimé l’attente d’environ 30 secondes avant le premier mot.
Enfin, LM Studio demande macOS 14 ou plus et ne prend pas en charge les Mac à processeur Intel.
Le dossier d’essai LM Studio contient les fichiers, les questions et les réponses attendues pour refaire ces essais chez vous.
Mon tuto pour résumer un PDF avec ChatGPT, Claude, Copilot ou Gemini porte sur les documents que vous pouvez envoyer en ligne. Vous pouvez aussi lire où vont les données envoyées à Claude et le tuto du Chat de Mistral, devenu Vibe.
J’ai fait ces essais le 14 octobre 2026 sur mon MacBook Pro M3 Pro de 18 Go, sous macOS 26.4.1, avec LM Studio 0.4.26. Les captures ne sont pas retouchées. Un assistant IA, Claude, a fait les clics et saisi les demandes sur mon Mac. J’ai recopié les réponses depuis l’historique de LM Studio. Pour le premier essai sur le contrat, le modèle avait été chargé en ligne de commande avec un contexte de 32 768 jetons. J’ai refait et capturé le réglage dans l’application le même soir. J’ai aussi refait la question une fois avec « Think » éteint. Les essais des préréglages après correction des consignes et celui du bon de commande scanné sont passés par le serveur local de LM Studio, sur le même Mac et avec le même modèle. Ils n’ont pas de capture ; j’en ai gardé les réponses et les temps.